Python调用http请求(附带json小处理)
当我们在Python中需要调用HTTP请求,并处理返回的JSON数据时,可以使用requests库来简化这个过程。下面是一段示例代码,展示了如何在Python中调用HTTP请求,并对返回的JSON数据进行处理: import requestsimport jsondef send_request(url, data): headers = {'Content-Type': 'application/json'} response = requests.post(url, data=json.dumps(data), headers=headers) if response.status_code == 200: # 请求成功,处理返回的JSON数据 json_data = response.json() # 进行进一步的处理操作 print(json_data) else: # 请求失败 print('...
Python mp4 转 jpg 脚本
#!/usr/bin/env python # _*_ coding:utf-8 _*_import cv2import osimport numpy as npimport mathimport requestsimport jsonimport base64from threading import Timerimport timefrom pprint import pprintfrom PIL import Image, ImageDraw, ImageFontimport sysreload(sys)sys.setdefaultencoding('utf-8')def curl(url): headers = {} response = requests.get(url, headers=headers) # pprint(response) return json.loads(response.text)def getInfo(file_path): info = {} ...
Aws 非公开桶资源 PHP sdk 解决方案
<?phpuse Aws\S3\S3Client;use Model\Main\Config\DbModel;class AwsOss{ const IMG = 1; const MP4_VIDEO = 2; /** * 获取解密后 base64文件 * @cli php cli.php Test getObjectUrl * @param string $url * @param int $fileType 1 图片 2 mp4视频 * @return string * @throws \Exception */ public static function getUrlBase64(string $url, int $fileType) { $config = DbModel::formatDbConfig(AwsOss::AWS_OSS_PUBLIC_TAG); return self::getKycBase64File($url,...
使用`JSON.stringify()`生成漂亮格式的JSON字符串
使用JSON.stringify()生成漂亮格式的JSON字符串在JavaScript中,JSON.stringify()是一个常用的方法,用于将JavaScript对象转换为JSON字符串。默认情况下,生成的JSON字符串是紧凑的,不易阅读和理解。然而,我们可以通过使用一些参数和技巧,使生成的JSON字符串呈现漂亮的格式。本文将介绍如何使用JSON.stringify()生成漂亮格式的JSON字符串。 使用JSON.stringify()生成漂亮格式的JSON字符串JSON.stringify()方法的第三个参数可以用于控制生成的JSON字符串的格式。具体来说,我们可以使用该参数设置缩进空格数或缩进字符串。下面是一个示例代码,展示了如何使用JSON.stringify()生成漂亮格式的JSON字符串: const data = { name: "John", age: 30, city: "New York"};const prettyJsonString = JSON.stringify(data, nul...
手把手教你用Strace诊断问题
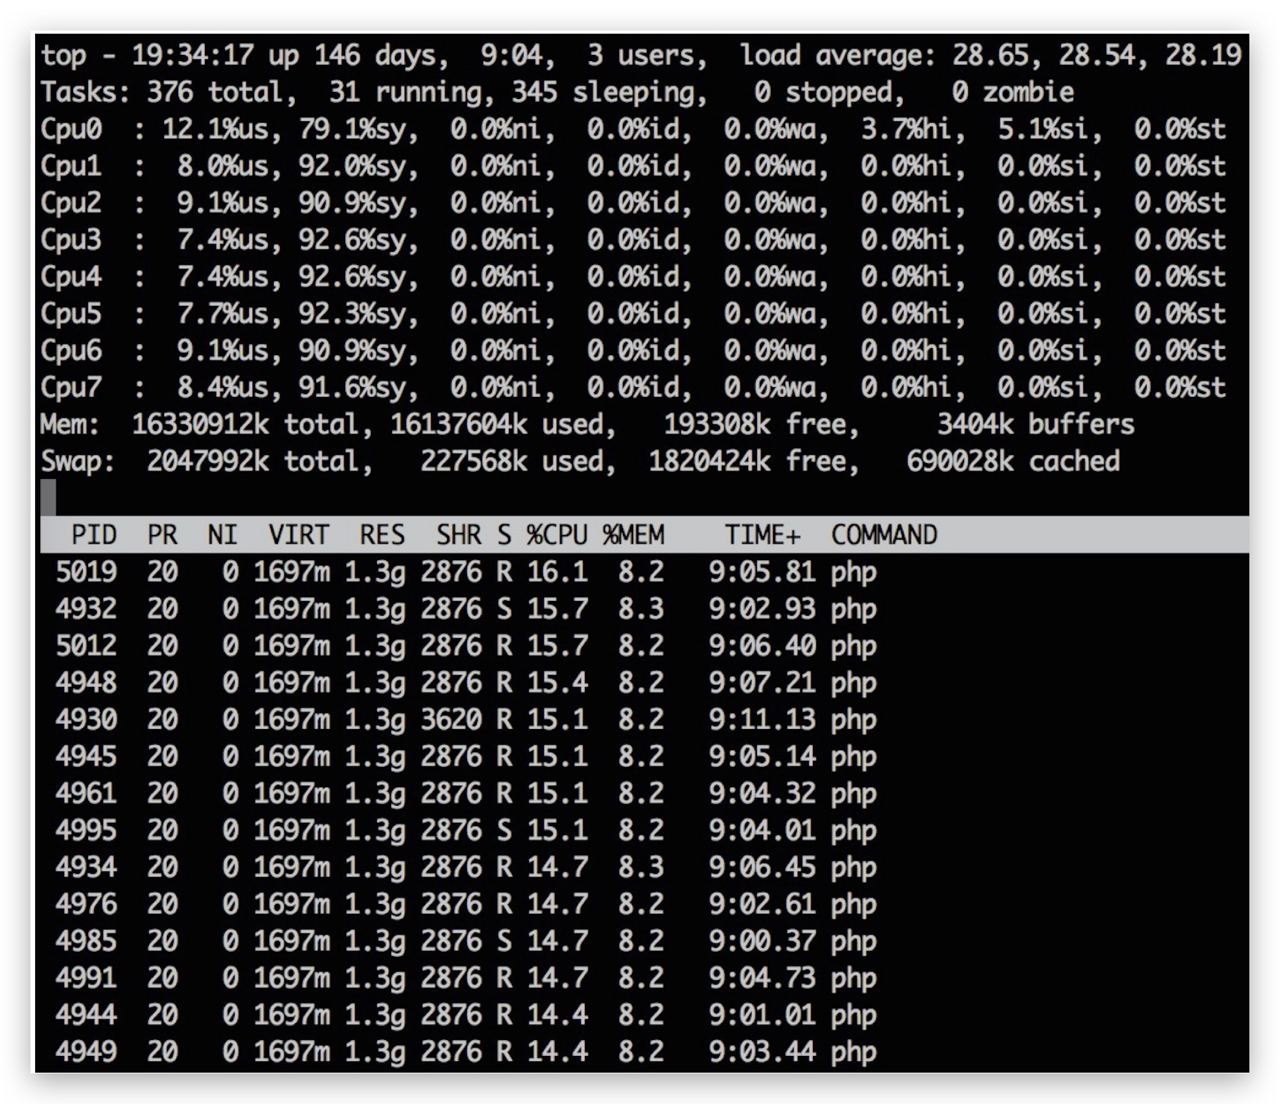
早些年,如果你知道有个 strace 命令,就很牛了,而现在大家基本都知道 strace 了,如果你遇到性能问题求助别人,十有八九会建议你用 strace 挂上去看看,不过当你挂上去了,看着满屏翻滚的字符,却十有八九看不出个所以然。本文通过一个简单的案例,向你展示一下在用 strace 诊断问题时的一些套路。 如下真实案例,如有雷同,实属必然!让我们看一台高负载服务器的 top 结果: 技巧:运行 top 时,按「1」打开 CPU 列表,按「shift+p」以 CPU 排序。 在本例中大家很容易发现 CPU 主要是被若干个 PHP 进程占用了,同时 PHP 进程占用的比较多的内存,不过系统内存尚有结余,SWAP 也不严重,这并不是问题主因。 不过在 CPU 列表中能看到 CPU 主要消耗在内核态「sy」,而不是用户态「us」,和我们的经验不符。Linux 操作系统有很多用来跟踪程序行为的工具,内核态的函数调用跟踪用「strace」,用户态的函数调用跟踪用「ltrace」,所以这里我们应该用「strace」: shell> strace -p <PID>...
Swoole 使用 Xhprof 调试 HTTP服务
昨天服务出了问题,生产环境代码需要优化 一般我们会通过几种方式分析:日志法:通过各种日志,查看耗时,找出相应的问题,但这种方法有几个缺点:粒度太粗,不好控制侵入性太强,需要人工打点性能指标不够,只能分析出大致的耗时,但不能分区i/o, cpu时间乖 xdebug:目前最牛逼的性能分析工具,可以无侵入式的详细的记录完整的调用链,遗憾的是与swoole不兼容xhprof: facebook出口的一款性能分析工具,简单易用,问题是:后期不维护了,对现在的php版本以及swoole支持度都不好第三方的apm工具: 不可控,也不如前面2位,对swoole支持也不好找到一个网站:https://tideways.com/,维护并持续更新xhprof,使之能支持php7 也支持在swoole下跑 安装 tideways_xhprof# 克隆扩展$ git clone https://github.com/shenzhe/php-xhprof-extension $ cd php-xhprof-extension/ # 没发现phpize $ phpize --version ...
MySQL — InnoDB 缓冲池 Buffer Pool
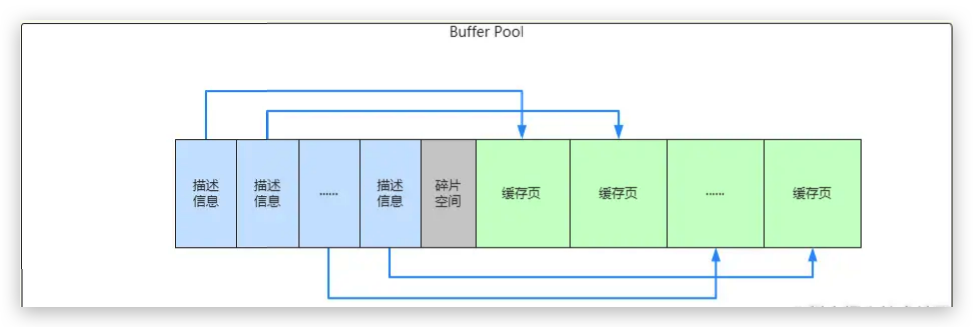
缓冲池 通过前面几篇文章,我们已经了解到 InnoDB 存储引擎是基于磁盘存储的,并将其中的记录按照页的方式进行管理。但由于CPU速度与磁盘速度之间的鸿沟,通常都会将数据加载到内存中来操作数据,以此提高数据库的整体性能。InnoDB 设计了一个缓冲池(Buffer Pool),当需要访问某个页时,就会把这一页的数据全部加载到缓冲池中,这样就可以在内存中进行读写访问了。对于数据库中页的修改操作,也是先修改在缓冲池中的页,然后再以一定的频率刷新到磁盘上。有了缓冲池,就可以省去很多磁盘IO的开销了,从而提升数据库性能。 注意即使只访问页中的一条记录,也需要把整个页的数据加载到内存中。前面有说过,通过索引只能定位到磁盘中的页,而不能定位到页中的一条记录。将页加载到内存后,就可以通过页目录(Page Directory)去定位到某条具体的记录。 Buffer Pool 结构 MySQL服务器启动的时候就会向操作系统申请一片连续的内存,即 Buffer Pool。默认配置下 Buffer Pool 只有128MB 大小,我们可以调整 innodb_buffer_pool_size 参数来...
MySQL 5.7下InnoDB对COUNT(*)的优化与MySQL 5.6性能对比
在MySQL 5.7 COUNT()会选择聚集索引,进行一次内部handler函数调用,即可快速获得该表总数 执行计划显示:Extra:Select tables optimized away 5.7以前的版本中,COUNT()请求通常是:扫描普通索引来获得这个总数。 执行计划显示: Extra:Using index 如果聚集索引较大(或者说表数据量较大),没有完全加载到buffer pool中的话,MySQL 5.7的查询方式有可能反而会更慢,还不如用原先的方式(MySQL 5.6) 解决办法:强制走普通索引,不过还需要加上WHERE条件,否则还是不行 select count() from stock force index(idx_stock) where id >0;extra:using where,using index
升级MySQL 5.7:开发人员需要注意的坑
升级MySQL 5.7:开发人员需要注意的坑MySQL 5.7是一款广泛使用的关系型数据库管理系统,它引入了许多新功能和改进。然而,升级到MySQL 5.7可能涉及一些潜在的问题和坑,开发人员需要特别注意。本文将探讨升级MySQL 5.7时开发人员需要注意的一些常见坑,并提供相应的解决方案。 1. 更严格的SQL模式MySQL 5.7引入了更严格的SQL模式,默认情况下使用STRICT_TRANS_TABLES和ONLY_FULL_GROUP_BY模式。这可能导致一些旧的应用程序或查询出现问题,例如: 默认值插入错误:如果插入的数据不符合列定义的规则,MySQL 5.7可能会抛出错误,而不是自动转换或使用默认值。 GROUP BY语句错误:MySQL 5.7要求在GROUP BY语句中的选择列表中的非聚合列必须出现在GROUP BY子句中。 解决方案:检查并更新应用程序代码以符合更严格的SQL模式。可以使用SET sql_mode命令来修改SQL模式,或者在配置文件中进行全局设置。 2. 更改的身份验证插件MySQL 5.7引入了新的身份验证插件caching_sha2_...
MySQL 优化器参数derived_merge导致多表关联SQL性能及其低下
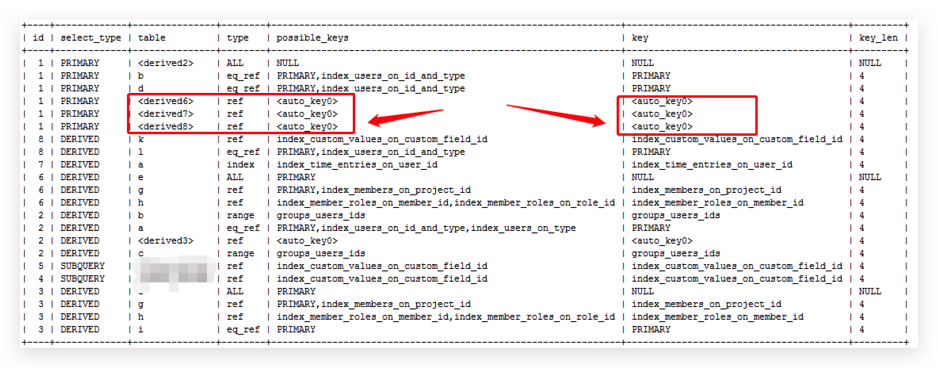
最近,MySQL维护中,遇到一个问题,通条SQL语句,在mysql 5.6的测试环境中执行速度不到1秒,但是在 mysql 5.7生产环境中执行却要近5分钟,mysql 5.7中同样的数据库同样的数据量,更新完表的统计信息后执行 速度还是要2分钟。本次问题的处理与sql语句本身没有关系,只跟mysql数据库自身的优化器参数相关,下面是 问题的分析排查过程,问题分析中的sql语句不需要显示,可以明确sql是多表join连接并且业务不允许更改。 1、首先,查看测试环境和生产环境中,mysql的sql语句的执行计划--测试环境,执行计划只需显示局部能说明问题即可 --生产环境,执行计划只需显示局部能说明问题即可 2、从测试与生产环境sql语句的对比可以明显发现,sql的执行计划不一致,后续排查中发现a、测试环境中sql涉及的表和索引的统计信息都是当天最新的,而生产环境中的相关表和索引的统计信息比较陈旧b、测试环境 mysql大版本为5.6,生产环境mysql大版本为5.7 3、问题处理a、由于sql执行计划不一致,且生产环境统计信息比较旧,重新收集生产环境表的统计信息,收集后s...