
VS Code 多家 AI Agent 集成使用指南(Copilot / Claude Code / Codex / Gemini / DeepSeek)
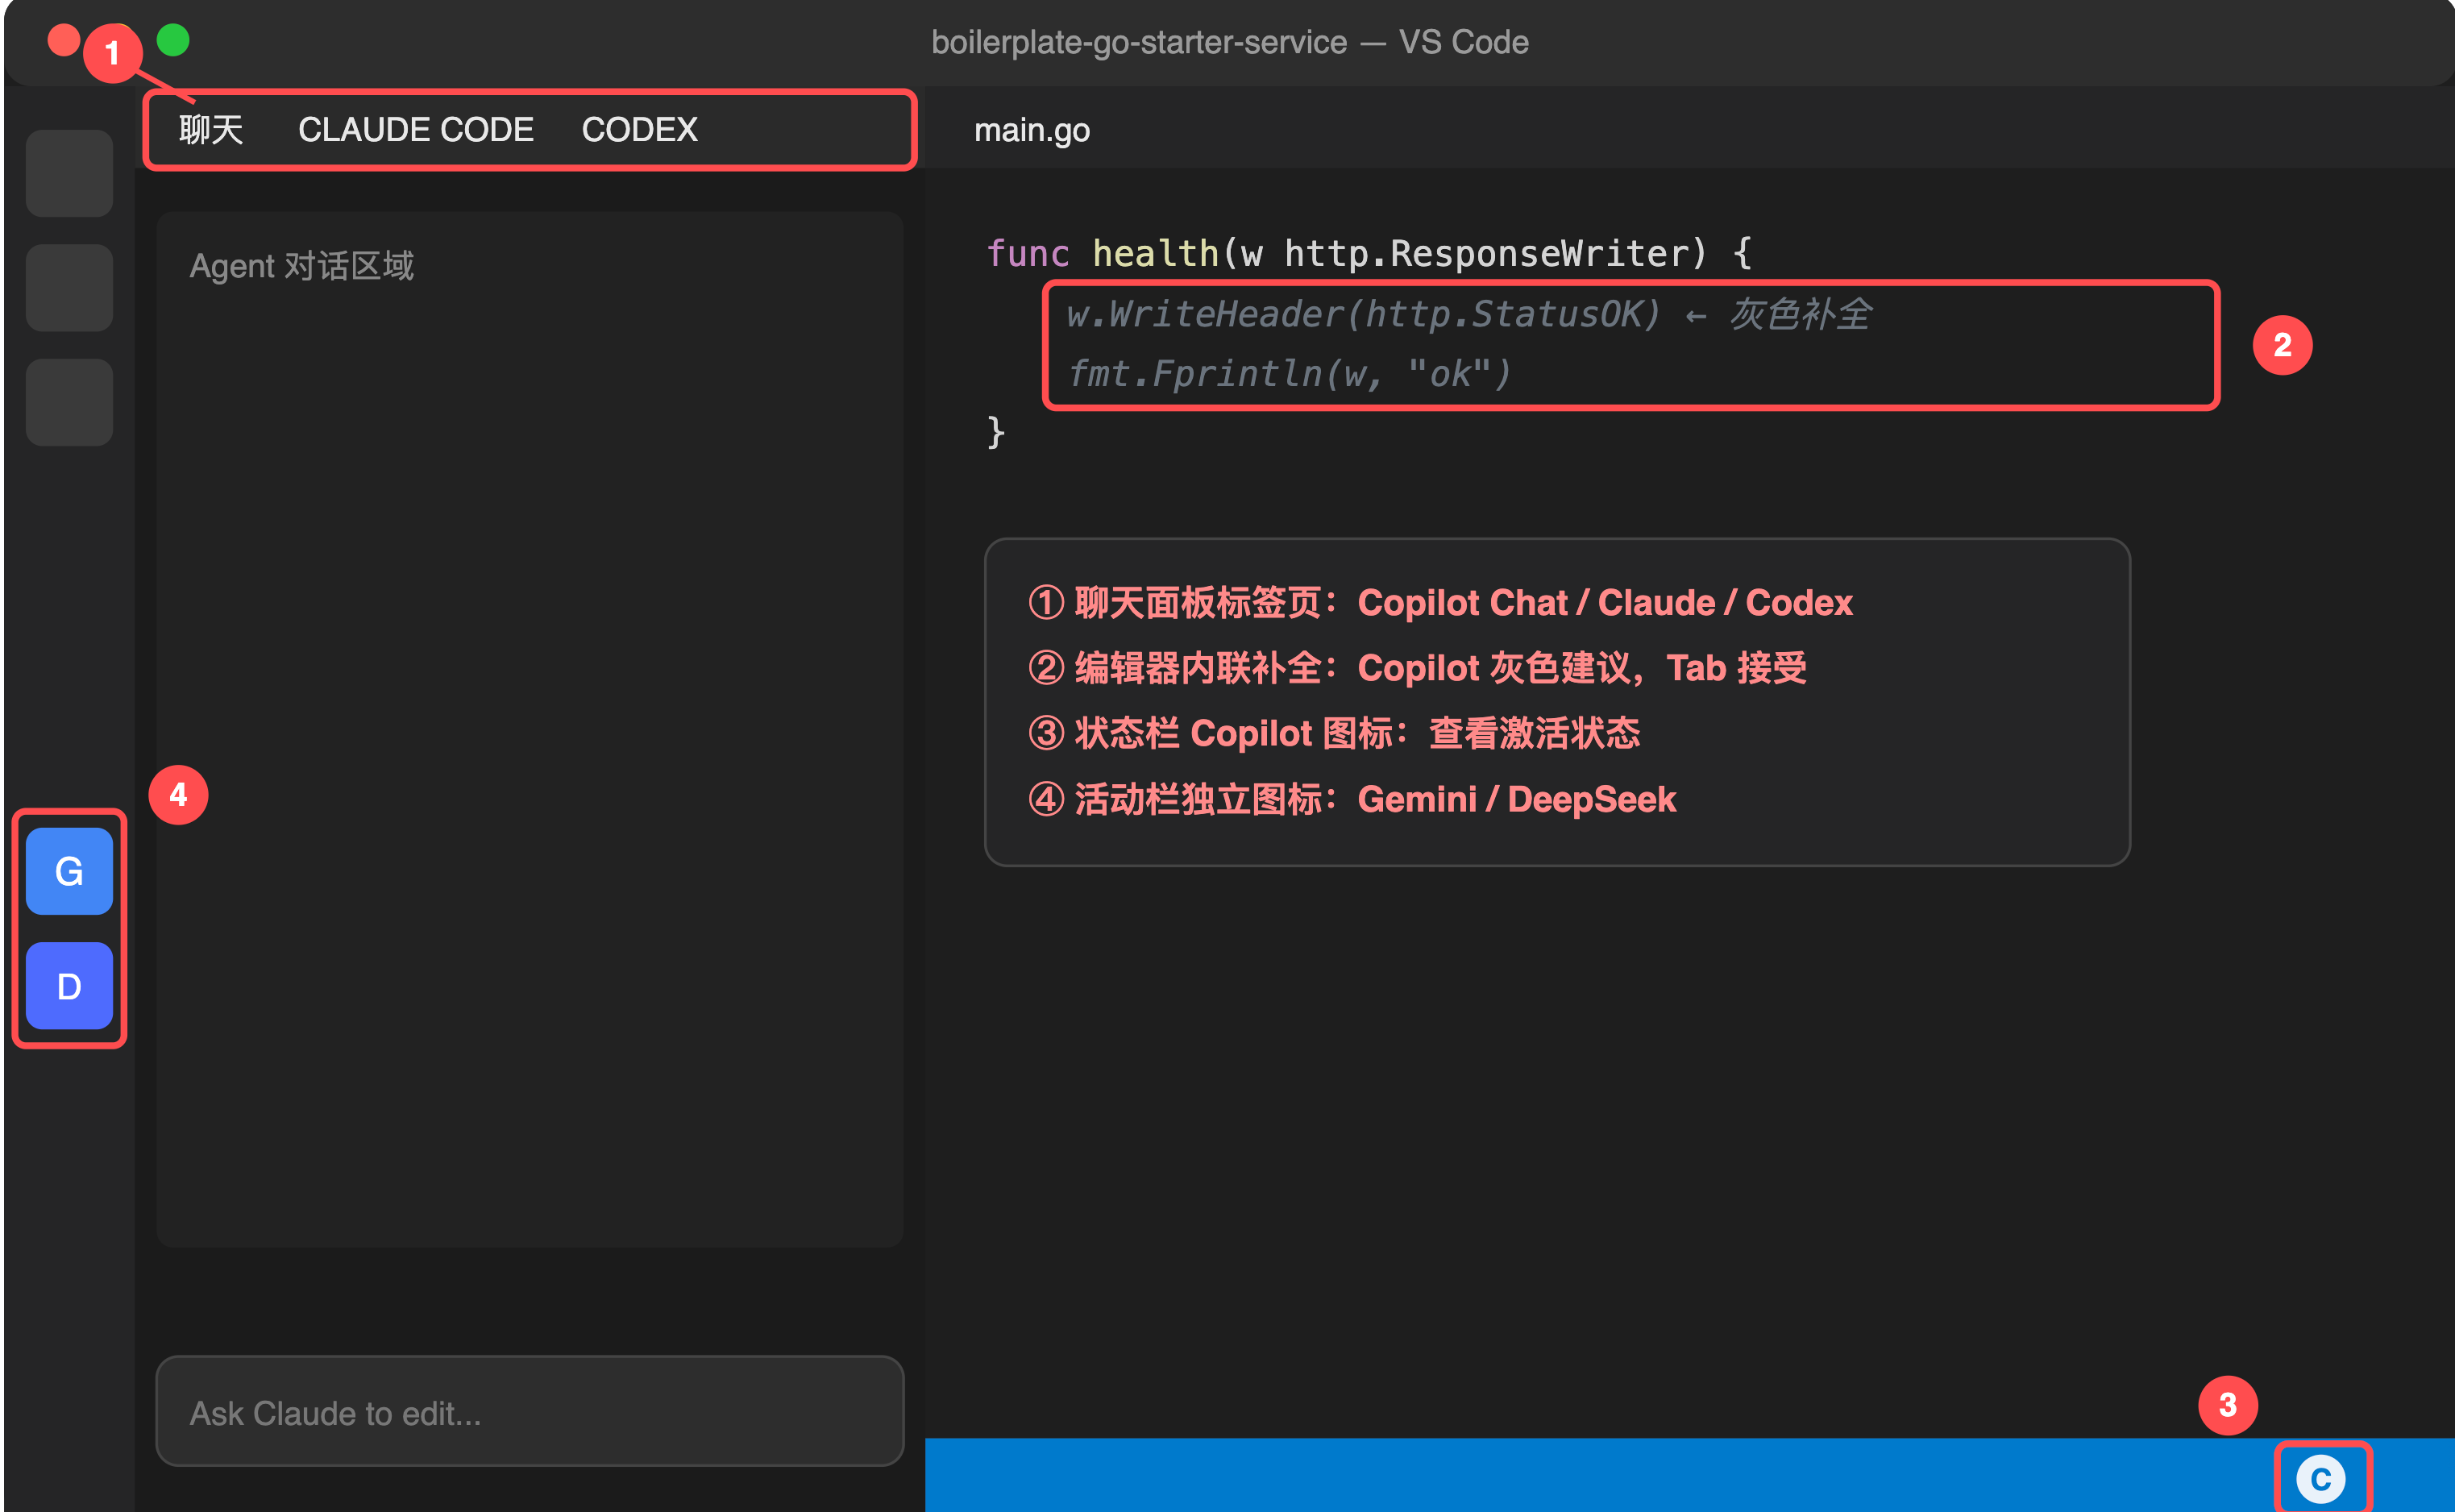
一台 VS Code,同时接入 5 家 AI 厂商。本文整理每家的安装方式、唤起入口、核心快捷键、适用场景,以及它们之间该怎么配合使用。 环境:macOS + VS Code(已汉化) 目录 一图看懂:5 家 AI 在 VS Code 里的位置 通用快捷键速查表 GitHub Copilot 使用方式 Claude Code 使用方式 Codex (OpenAI) 使用方式 Gemini Code Assist 使用方式 DeepSeek 使用方式 5 家对比:什么场景用哪个 常见问题排查 一、一图看懂:5 家 AI 在 VS Code 里的位置 📷 截图说明:截一张 VS Code 完整窗口,用红框标注:① 左上角聊天面板的标签页(聊天 | CLAUDE CODE | CODEX)② 编辑器中的灰色内联补全(Copilot)③ 右下角状态栏的 Copilot 图标④ 左侧活动栏的 Gemini / DeepSeek 图标 5 家 AI 分布在三个区域: 区域有谁干什么编辑器内(内联)Copilot实时灰色代码补全,按 Tab 接受聊天面板(标签页)...
RabbitMQ 联调踩坑实践:对接 CFD 桥方 Queue API
场景:衍生品对冲侧通过 RabbitMQ 接入桥方(CFD 流动性桥)的 Queue API,订阅对冲账户的余额与持仓推送。栈:Go + github.com/rabbitmq/amqp091-go + 长驻消费者进程 + 结构化诊断日志([CFD-MQ-DIAG])。核心结论:MQ「能连上」≠「能消费」≠「能认证」≠「能收推送」——四层要分开验证,分开记日志。 1. 先建立正确的心智模型1.1 两套凭证、两层协议这是整个联调中最容易踩的坑:RabbitMQ 传输层凭证和Queue API 应用层凭证是两套完全独立的账号体系。 层级用途账号示例(脱敏)配置项RabbitMQ 传输层TCP/TLS 建连、Publish / Consumemq_client_userCFD_MQ_USER / CFD_MQ_PASSWORDQueue API 应用层发 msg=31 认证、订阅账户推送trader@example.com(客户端登录邮箱)CFD_MQ_API_USERNAME / CFD_MQ_API_PASSWORD 踩坑 #1:把 RabbitMQ 密码填进了 CFD...
聊聊长连接协议选型:从 MQTT、WebSocket 到 HTTP/3 的一点畅想
写在前面:这篇是我自己整理长连接这块时记的笔记,不算特别专业,更多是工程视角的”大白话版”。如果你正在做实时推送、物联网、IM 这类需要保持长连接的活儿,希望能给你一点参考。 关于我一个普通后端开发,平时主要写服务端,偶尔也碰点前端和嵌入式。最近因为项目上需要做实时推送,把几个长连接方案都摸了一遍,顺手把学到的和踩到的记下来,整理成这篇笔记。 不算什么专家,就是把自己理解的东西用大白话讲一遍,有说得不对的地方欢迎指正。 一、先说结论:没有银弹长连接协议的选型,本质上是在实时性、可靠性、资源开销、网络穿透能力、生态成熟度这几个维度之间做权衡。没有哪个方案是全能的,脱离场景谈”哪个最好”都是耍流氓。 先放一张全景图,帮你建立个整体印象: mindmap root((长连接方案)) HTTP 长轮询 实现简单 兼容性最好 实时性差/资源浪费 适合兜底 WebSocket 全双工 Web 端事实标准 需自建重连/心跳 适合 IM/协同/弹幕 MQTT ...
行式、列式、向量数据库怎么选?一篇写给工程师的选型指南
面向有经验的后端/数据/平台工程师。本文不堆术语,只讲清楚三类数据库各自擅长什么、在什么场景下会踩坑,以及真实业务里怎么组合使用。原理部分点到为止,深入链接放在文末。 数据库选型这件事,八成的争论其实源于一个误会:把”存储模型”当成了”产品好坏”来比。行式、列式、向量,本质是三种不同的数据组织方式,各自为一类访问模式做了极致优化。选错的代价不是”慢一点”,而是整个架构跑偏。 下面按”它怎么存 → 适合什么 → 什么时候别用 → 真实案例”的结构,逐个拆开。 一、行式数据库:为”一次操作一条记录”而生它怎么存行式数据库把一整条记录的所有字段连续存放在磁盘上: Block 1: [1, 张三, 25, 北京] [2, 李四, 30, 上海]Block 2: [3, 王五, 28, 广州] [4, 赵六, 35, 深圳] 读一条完整记录,一次磁盘 IO 就能拿全所有字段。 📊 建议配图:行式存储 vs 列式存储的磁盘布局对比图(可搜索 “row vs columnar storage layout”) 适合什么场景行式数据库的统治区是 OLTP(在...
Apache Pulsar 订阅模式与消费模型深度解析(Go 实战)
在落地 Pulsar 的过程中,开发者最容易踩的坑集中在两个问题上: 问题一:”我有多个消费者,消息是怎么分发的?顺序能保证吗?” 问题二:”消费者处理业务逻辑很慢,会不会把整个消费流程阻塞住?” 这两个问题的答案,分别对应 Pulsar 的订阅模式(Subscription Type) 和消费模型(Consumption Pattern)。 本文基于 Go 语言,通过完整可运行的代码,逐一拆解四种订阅模式,并给出生产环境中解决阻塞问题的异步消费方案。 环境准备# 1. 启动本地 Pulsar(Docker)docker run -d --name pulsar \ -p 6650:6650 \ apachepulsar/pulsar:latest \ bin/pulsar standalone# 2. 初始化 Go 项目go mod init pulsar-demogo get github.com/apache/pulsar-client-go/pulsar# 3. 运行 Demogo run pulsar_subscription_demo.go 一、基础概...
Redis 二级缓存在撮合引擎中的落地方案
场景:撮合引擎多 Pod 部署,每个 Pod 维护本地 L1 内存深度数据,如何通过 Redis L2 实现跨 Pod 无损同步? 一、背景与问题定义撮合引擎(Matching Engine)是交易系统的核心,订单簿(Order Book)的买卖深度数据有以下特点: 写频率极高:每秒数千次挂单、撤单、成交 读频率更高:行情推送、风控查询、前端展示 强一致性要求:深度数据不能乱序、不能丢失 延迟敏感:毫秒级响应,不能每次都走 Redis 因此,撮合引擎不会把深度数据持续维护在 Redis,而是: L1(JVM 堆内存)= 单一真相来源(Source of Truth)L2(Redis) = 跨 Pod 同步介质 + 故障恢复快照 核心问题就变成:如何让 L1 的变更,通过 L2,无差别地同步到其他 Pod 的 L1? 二、整体架构┌─────────────────────────┐ ┌─────────────────────────┐│ Pod A │ │ Pod B ...
性能需求应该怎么提?关键功能不能跪
本文是《产品要懂得的性能指标:性能需求,你要好好提》的下篇。 上一篇解决的是“产品需要看懂哪些性能指标”:响应时间、并发用户数、吞吐量、成功率、可用性、资源利用率、数据规模、客户端流畅度,以及启动、耗电和流量。 但认识指标只是第一步。真正写需求时,产品还要解决几个更现实的问题:哪些功能必须重点保障?性能需求什么时候提?写到什么程度才可以验收?最后达不到又该怎么办? 这篇不再逐个解释指标,而是继续往下讲,怎么把指标真正写进需求、带进评审,并变成可以验收的标准。 产品经理写需求时,通常会把主要精力放在业务流程上:用户点哪里、页面展示什么、什么情况下成功、什么情况下失败。 功能写得很细,性能却经常只留下一句话: 系统响应要快,用户多的时候不能卡。 这句话看起来提了性能,实际上跟没提差不多。 多快算快?多少用户算多?哪个功能不能卡?可以失败多少次?持续一分钟和持续一小时是不是同一个要求?这些问题不说清楚,开发无法判断要按什么规模设计,测试也没有明确的验收标准。 性能需求很容易被忽视,却无比重要。功能做错了,可能只是某个流程不好用;性能没想清楚,可能是用户全部涌进来的时候,登录...
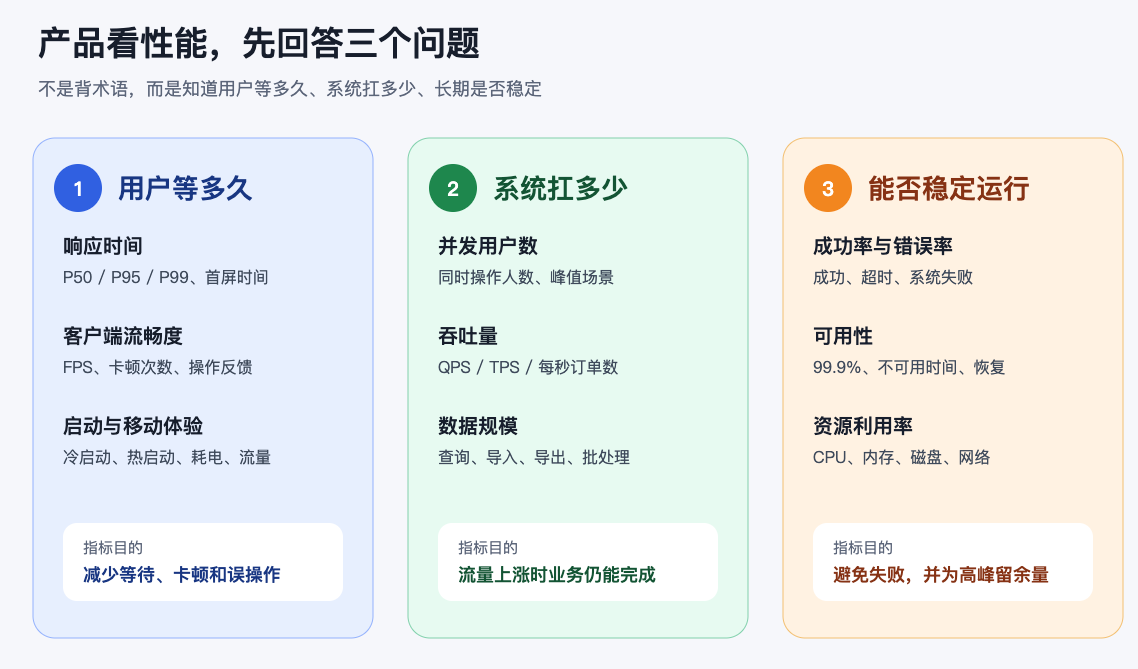
产品要懂得的 性能指标:性能需求,你要好好提
产品经理提性能需求时,最容易写出的一句话是: 页面打开要快一点,系统要稳定,用户多的时候也不能卡。 这句话方向没错,但没法开发,也没法验收。 “快一点”到底是 1 秒还是 5 秒?“用户多”是 100 人同时在线,还是 100 人同一秒提交订单?“稳定”是全年不宕机,还是请求成功率达到 99.9%?如果这些问题没有说清楚,开发只能凭经验实现,测试也只能凭感觉验收。 一份可执行的性能需求,至少要说清楚四件事: 在什么场景下,用多大的数据量和访问压力,要求哪个指标达到什么数值。 下面是产品经理需要掌握的 9 类性能指标。 这 9 类指标可以先分成三个问题:用户等多久、系统扛多少、能否稳定运行。 产品不需要把自己变成运维工程师,但要知道每个指标看什么参数、解决什么问题。 1. 响应时间:用户要等多久响应时间,是从用户发起操作,到用户看到结果所经历的时间。 它不是一个单独的“后端接口耗时”,而是一整条请求链路的总和: 用户操作 ↓客户端处理 ↓网络传输 ↓网关、鉴权与排队 ↓服务端业务处理 ↓数据库、缓存及外部服务调用 ↓结果返回 ↓客户端解析、渲染与展示 ...
从"只能看 Markdown"到"什么都能看"——我和 Claude Code 一起重造 markdownShow
这篇文章本身就是一个 .md 文件。你现在看到的图片、下面的内联 HTML 卡片、还有那些 Mermaid 图,全都是 markdownShow 直接渲染出来的——这正是我想让它做到的事。 缘起:一个”拖进去就能看”的小工具一开始,markdownShow 只做一件事:把 .md 拖进浏览器,立刻渲染。代码高亮、目录 TOC、亮/暗主题、Mermaid 图表,再加一层 DOMPurify 防脚本注入——一个纯前端、零后端、能装成 PWA 的 Markdown 查看器,部署在 GitHub Pages 上。 它够用,但有个我越用越明显的痛点:我的文件夹里不只有 md。还有 PDF 报告、单页 HTML 计算器、一堆截图、XMind 导出的思维导图。每次看它们都得切到别的应用。于是我打开 Claude Code,开始把这个”只能看 md 的工具”,改造成”我本地文档的统一查看器”。 我是怎么和 Claude Code 协作的我的节奏很简单,也一直这么要求它: 一次只做一件事,做完立刻汇报,别一口气堆一堆; 不许臆测——改之前先看代码、先复现,改完要真的跑测试、真...
[踩坑] MySQL 8.0 小版本升级踩坑:max_connect_errors 默认值 100 引发的连接异常
背景最近做了一次 MySQL 8.0 的小版本升级,升级完重启之后业务侧开始报连接异常,日志里出现了一些奇怪的 warning。表面看不致命,但实际有部分客户端被 MySQL 直接拉黑了连不上。最后 DBA 排查出来是 max_connect_errors 这个参数默认值太小导致的,改大之后问题消失。 记录一下整个过程,避免下次再踩。 现象升级重启之后,错误日志里陆续出现这类 warning: [2026-04-30 05:25:49 #20157.0] WARNING del (ERRNO 800): failed to delete events[656], it has already been removed[2026-04-30 05:38:49 $24029.0] WARNING kill_event_workers(:595): waitpid(24423) failed, Error: No child processes[10][2026-04-30 05:38:55 @26321.0] WARNING set_max_connection: max_...




