
[踩坑] Swoole 启动报错 `FactoryProcess_manager_start failed` 排查记录:System V 消息队列耗尽
一、问题现象某天重启一个基于 Swoole 的 PHP 服务,直接挂了。日志里报: [27-Apr-2026 09:37:03] PHP Fatal error: Swoole\Server::start(): failed to start server. Error: start: FactoryProcess_manager_start failed in /opt/webserver/binance-uper/vendor/ZScript/Server/Server.php on line 124 第一反应是端口被占了,但 netstat / ss 一看,端口干干净净,没人占用。 二、初步排查方向(都不是)排查 FactoryProcess_manager_start failed 这个错时,常见怀疑对象有这几个: 残留的 master / manager 进程没退干净 —— ps aux | grep php 看一下,没有。 pid_file / unix sock 残留文件 —— /tmp 下没有相关残留。 ulimit -u(...
CEX 业务数据库选型对比
CEX 业务特点鲜明:高并发、低延迟、强一致、海量历史数据、实时风控与分析并存。单一数据库很难全覆盖,通常是组合方案。 五款数据库核心定位数据库类型核心优势主要短板MySQL单机 OLTP(可分库分表)成熟稳定、生态完善、事务强单机容量和并发有瓶颈,分库分表运维复杂PostgreSQL单机 OLTP(功能最强)SQL 标准好、JSON/GIS/窗口函数强、扩展性强分布式方案不如 MySQL 成熟,高并发写入弱于 MySQLTiDB分布式 HTAP(偏 TP)水平扩展、MySQL 协议、强一致事务延迟比单机 MySQL 高、资源消耗大DorisMPP OLAP实时分析、导入快、查询秒级不适合事务、高频点更新弱ClickHouse列存 OLAP超大数据量聚合极快、压缩率高JOIN 弱、更新删除代价高、并发查询能力差 CEX 核心业务模块与数据库匹配1. 撮合引擎 / 订单簿 通常不落数据库,在内存中用自研引擎(Disruptor、LMAX 模式)跑 数据库只做持久化归档,任何传统 DB 都扛不住撮合级别的延迟要求(微秒级) 2. 账户 / 资金 ...
[踩坑] 后端性能优化:一天排查的 4 个问题
记录今日遇到的四个典型后端问题,涵盖数据库迁移、浏览器并发限制、权限缓存、Nginx 代理配置。 1. MySQL 聚合过慢 → 迁移 ClickHouse问题接口中存在大量 foreach 循环聚合查询,随着数据量增长,MySQL 在多条件聚合场景下性能瓶颈明显,接口响应逐渐变慢。 解决迁移至 ClickHouse,利用其列式存储和向量化执行引擎提升聚合性能。 迁移注意点场景MySQLClickHouse去重计数COUNT(DISTINCT col)uniq(col)分组聚合GROUP_CONCATgroupArray()分页LIMIT offset, countLIMIT count OFFSET offset保留字一般无需处理user、date、index 等需加反引号 2. 接口耗时 5s,页面显示 12s → HTTP/1.1 并发限制问题页面同时发起十几个接口请求。HTTP/1.1 每个域名最多维持 6 个并行连接,其余请求在队列中等待。某个连接完成后,队列里的下一个才能发出。接口本身耗时 5s,但因后续接口需等待前面的连接 slot...
事务隔离级别深度解析:PostgreSQL vs MySQL
事务隔离级别是数据库并发控制的核心概念,直接影响系统的数据一致性与并发性能。SQL 标准(SQL-92)定义了四种隔离级别,但 PostgreSQL 和 MySQL(InnoDB)在实现细节上存在显著差异,理解这些差异是写出正确、高效 SQL 的关键。 一、并发问题:为什么需要隔离级别?在多事务并发执行时,可能出现以下四类问题: 1. 脏读(Dirty Read)事务 A 读取了事务 B 尚未提交的数据。若 B 回滚,A 读到的就是”幻觉数据”。 -- 事务 B(未提交)UPDATE accounts SET balance = 9999 WHERE id = 1;-- 事务 A(脏读)SELECT balance FROM accounts WHERE id = 1; -- 读到 9999(B 未提交) 2. 不可重复读(Non-Repeatable Read)事务 A 两次读取同一行,期间事务 B 修改并提交了该行,导致两次结果不同。 -- 事务 A 第一次读SELECT balance FROM accounts WHERE id = 1; -- 1000-- ...
使用 Kafka 替换定时任务的架构方案
标签:Kafka Golang 定时任务 事件驱动 架构设计Go Kafka 库:github.com/segmentio/kafka-go 为什么要替换定时任务?定时任务在小规模系统中运行良好,但随着业务增长,问题逐渐暴露: 问题描述时间耦合必须等到固定时间点才触发,实时性差重复执行多实例部署需要额外分布式锁,稍有不慎就重复执行全量扫描通常需要扫全表找待处理数据,数据量大时拖垮数据库失败难追踪没有自然的重试机制,失败了难以回溯扩展性差任务量增大时无法动态扩容消费能力 方案一:事件驱动替代状态轮询适用场景 订单支付后触发发货 用户注册后发送欢迎邮件 状态流转触发下游处理 流程对比❌ 旧方案(定时轮询)┌─────────────────────────────────────────────┐│ Cron Job(每 5 分钟) ││ ↓ ││ SELECT * FROM orders WHERE status='pai...
从 MySQL + TiDB 迁移至 PostgreSQL + Apache Doris —— 我们为什么做这个决定
背景我们的系统长期以来采用 MySQL(InnoDB) 作为 OLTP 主库,TiDB 作为分布式扩展层,整体承载了核心业务的读写和部分分析型查询。 然而,近期的外部变化让我们不得不重新审视这套技术选型: 云运营商开始停止维护 MySQL 8.4 以下版本,意味着旧版本将失去安全补丁和官方支持; MySQL 8.4 引入了大量不向前兼容的变更,升级成本极高,部分语法和行为与旧版本存在显著差异; TiDB 宣布在 MySQL 8.4 协议适配上存在严重兼容性问题,无法跟进升级,继续使用意味着与主库协议脱节,维护风险急剧上升。 在综合评估成本、风险与长期可维护性之后,我们决定: OLTP 层:MySQL → PostgreSQL OLAP / 分布式分析层:TiDB → Apache Doris 本文记录这次迁移的技术背景、差异对比与决策过程,供团队参考与后续回溯。 第一部分:MySQL → PostgreSQL为什么不选择继续升级 MySQL?问题描述不向前兼容8.4 废弃了大量旧语法(如 GROUP BY 隐式规则、部分函数行为),存量 SQL 改造量巨大...
Go 微服务从零到生产:完整学习路径
全局视角第一阶段 Go 基础 → 能写业务逻辑第二阶段 单体服务 → 能跑一个完整的 HTTP 服务第三阶段 拆分微服务 → 多个服务互相通信第四阶段 服务治理 → 服务发现、配置中心、链路追踪第五阶段 容器化 → Docker 打包,跑在任何地方第六阶段 编排部署 → Kubernetes 管理成百上千个容器第七阶段 流量治理 → Istio 控制服务间流量 第一阶段:Go 基础目标:能用 Go 写业务逻辑,看懂别人的代码。 核心概念// 1. 零值可用的结构体var a phparray.Arraya.Set("name", "Tom") // 直接用,无需 New()// 2. 错误处理(Go 没有 try-catch)data, err := json.Marshal(obj)if err != nil { return fmt.Errorf("mar...
Apache Doris 深度解析:与 MySQL、TiDB 的全面对比
一、Apache Doris 是什么?Apache Doris(原名 Palo,由百度开源)是一款现代化的 MPP(大规模并行处理)分析型数据库,专为实时数据分析场景设计。它基于 Google Mesa 论文的思想演进而来,是目前国内使用最广泛的 OLAP(联机分析处理)数据库之一。 核心特性 高性能 OLAP:基于列式存储 + 向量化执行引擎,聚合查询极速 实时数据写入:支持秒级数据摄入,写入即可见 标准 SQL:兼容 MySQL 协议,降低迁移成本 弹性架构:FE(前端)+ BE(后端)分离,水平扩展能力强 丰富的数据模型:Aggregate、Unique、Duplicate 三种模型覆盖多种场景 多表物化视图:自动命中,加速复杂查询 湖仓一体:通过 Catalog 直接查询 Hive、Iceberg、Hudi 等数据湖 典型应用场景场景说明实时报表业务大盘、用户行为分析广告数据分析点击率、转化漏斗等多维分析日志分析海量日志检索与统计数据中台统一数据分析服务层湖仓联邦查询不移动数据,直接分析数据湖 二、三者的本质定位在对比之前,首先明确三者的设计定位,这是理解一切差...
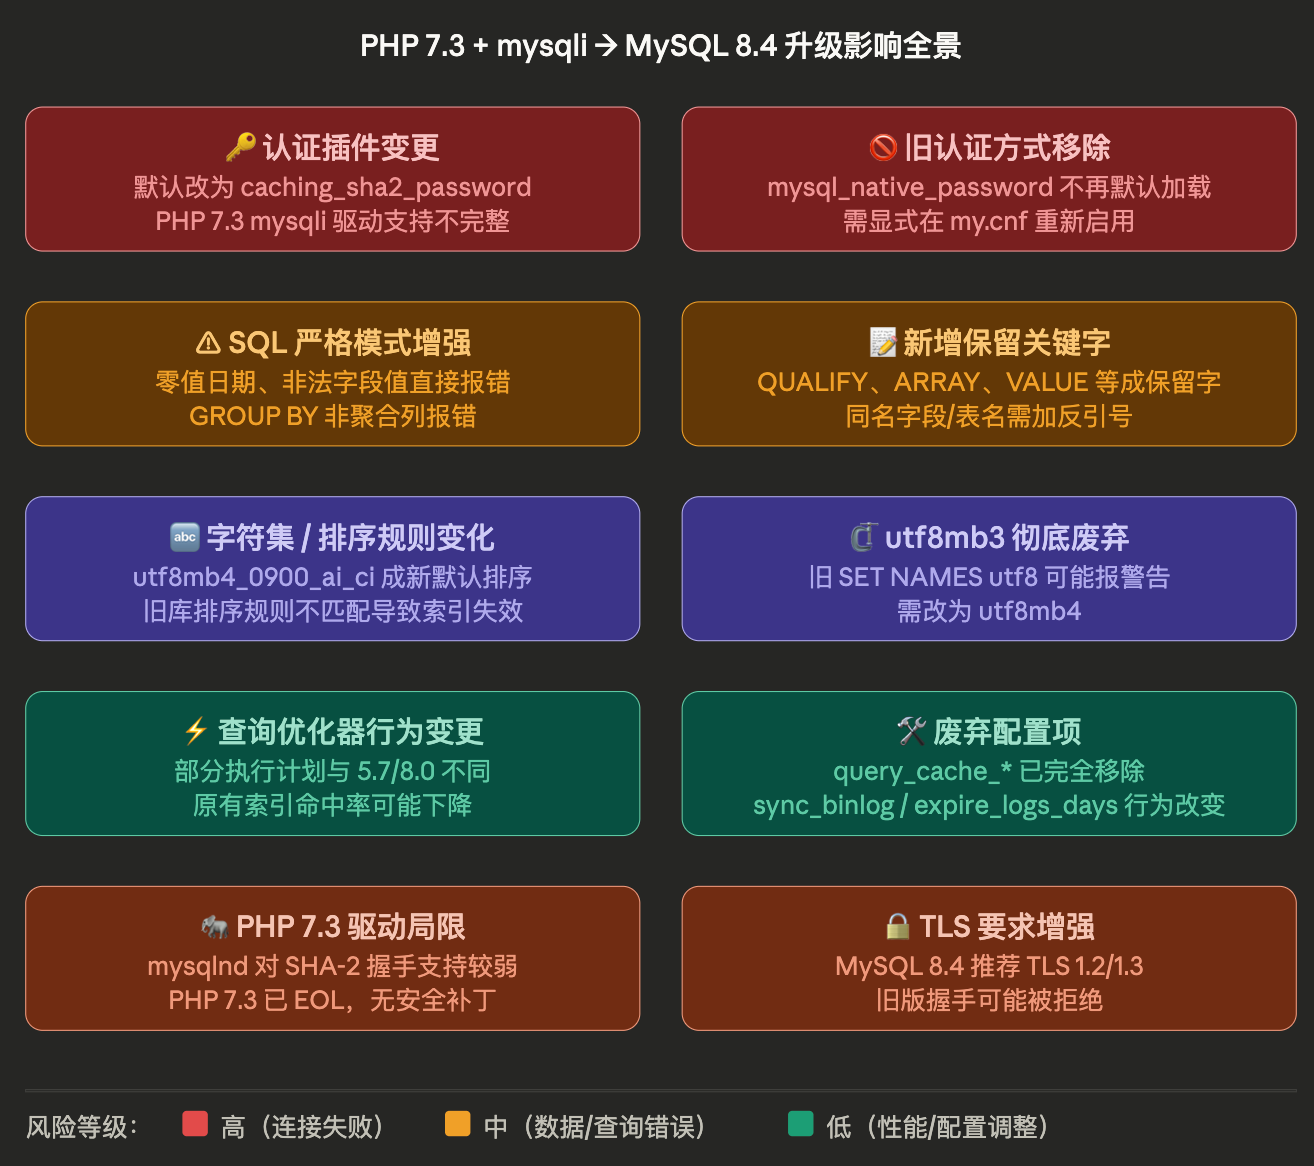
MySQL 8.0 升级 8.4:PHP 7.3 + Swoole 4.3 兼容性问题与修复方案
MySQL 8.0 升级至 8.4,属于小版本跨越,但 8.4 是一个 LTS 版本,做了若干破坏性变更。结合 PHP 7.3 + Swoole 4.3 的实际情况,整理出以下兼容性问题和对应处理方案。 影响概览问题严重程度影响范围mysql_native_password 插件被移除🔴 高连接直接失败Swoole 连接池持久连接行为异常🔴 高协程环境下连接错乱ONLY_FULL_GROUP_BY 更严格🟡 中部分查询报错新增保留关键字🟡 中SQL 语法错误废弃配置项导致启动失败🟡 中MySQL 无法启动默认排序规则变更🟢 低JOIN 排序规则冲突 问题一:mysql_native_password 插件被正式移除问题描述MySQL 8.0 已将默认认证插件改为 caching_sha2_password,但 mysql_native_password 仍作为内置插件保留。8.4 将其彻底移除,不再默认加载,需显式启用。 如果 8.0 时期的用户账号是用 mysql_native_password 创建的,升级 8.4 后连接会直接报错: mysqli::...
消息队列进阶:你必须掌握的六种队列模式
消息队列不只是”生产-消费”那么简单。在真实的业务场景中,我们需要面对消息消费失败、延时执行、顺序保障等各种复杂问题。本文梳理六种常见的队列模式,帮你建立完整的消息队列知识体系。 一、死信队列(Dead Letter Queue)是什么死信队列(DLQ)是用来存放无法被正常消费的消息的特殊队列。当一条消息反复消费失败、超过最大重试次数,或者因为格式错误无法解析时,它不会被直接丢弃,而是被转移到死信队列中”等待处理”。 你可以把它理解为消息系统的”回收站”——消息没有被直接删除,而是被隔离到一个专门的地方,等人来处理。 什么时候触发消息变成”死信”通常有以下几种原因: 消费失败达到最大重试次数:比如设置了重试 3 次,3 次都失败就进入 DLQ 消息 TTL 过期:消息在队列中等待超过了设定的存活时间 队列满了:队列达到最大长度,新消息无法入队,老消息被挤到 DLQ 消息被消费者主动拒绝(reject/nack 且不重新入队) RabbitMQ 示例# 声明死信交换机和队列channel.exchange_declare(exchange='dlx...




